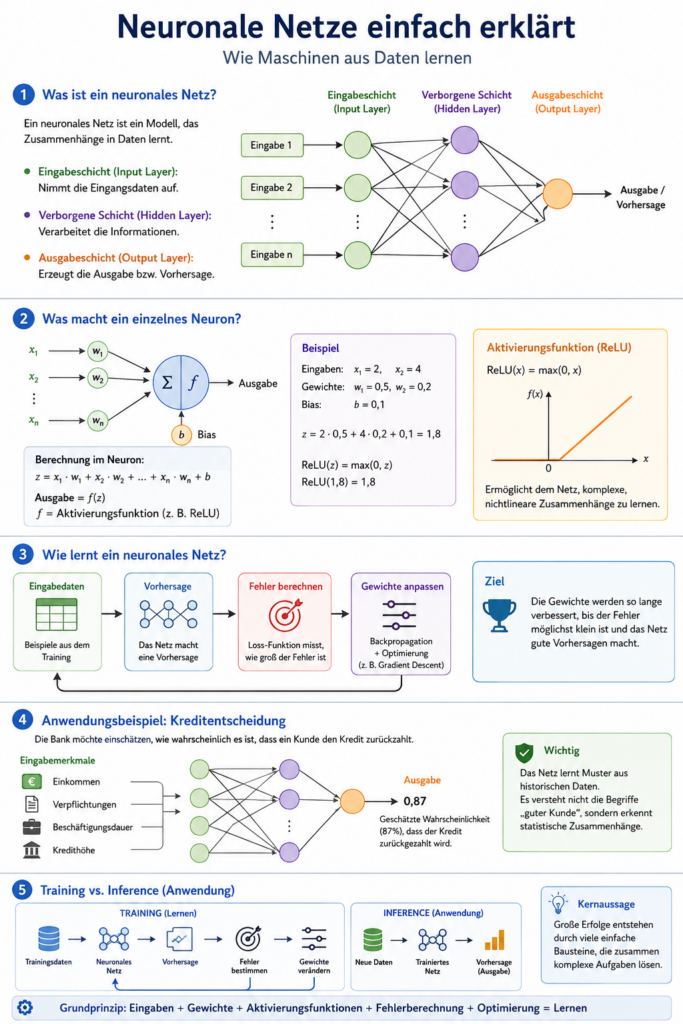
Neuronale Netze gehören zu den wichtigsten Technologien hinter moderner künstlicher Intelligenz. Sie helfen dabei, Bilder zu erkennen, Texte zu verarbeiten, Sprache zu verstehen oder Vorhersagen aus Daten abzuleiten.
Doch wie funktioniert ein neuronales Netz eigentlich? Die gute Nachricht: Das Grundprinzip lässt sich auch ohne höhere Mathematik verstehen. In diesem Beitrag bauen wir gedanklich ein kleines neuronales Netz auf und schauen uns anschließend ein konkretes Anwendungsbeispiel an.
Was ist ein neuronales Netz?
Ein neuronales Netz ist ein mathematisches Modell, das Zusammenhänge in Daten lernen kann. Die Idee ist im Prinzip von der Funktionsweise biologischer Nervenzellen inspiriert.
Das Netz besteht aus vielen kleinen Recheneinheiten, den sogenannten Neuronen. Diese sind miteinander verbunden und typischerweise in mehreren Schichten organisiert:
- Eingabeschicht (Input Layer): Sie nimmt die Eingangsdaten auf, zum Beispiel Messwerte, Merkmale eines Kunden oder Pixelwerte eines Bildes, und gibt sie an die nächste Schicht weiter.
- Verborgene Schicht (Hidden Layer): Hier werden die Informationen verarbeitet.
- Ausgabeschicht (Output Layer): Hier entsteht das Ergebnis z.B. eine Vorhersage, eine Wahrscheinlichkeit
Ein sehr kleines Netz könnte beispielsweise so aussehen:
Eingaben          Verborgene Schicht       Ausgabe

x₁ ───────┐          ○
           ├────────►○ ───────────────►    ○
x₂ ───────┘          ○
Die Kreise stehen dabei für einzelne Neuronen.
Was macht ein einzelnes Neuron?
Ein künstliches Neuron erhält eine oder mehrere Zahlen als Eingabe. Jede dieser Zahlen wird mit einem Gewicht multipliziert.
Nehmen wir zwei Eingaben:
- x₁ = 2
- x₂ = 4
Dazu besitzt das Neuron beispielsweise folgende Gewichte:
- w₁ = 0,5
- w₂ = 0,2
Vereinfacht berechnet das Neuron zunächst:
2 × 0,5 + 4 × 0,2 = 1,8
Zusätzlich besitzen Neuronen normalerweise einen sogenannten Bias. Er ist eine weitere Zahl, die zum Ergebnis addiert wird und dem Netz zusätzliche Flexibilität beim Lernen gibt.
Die grundlegende Berechnung lautet damit:
z = x₁ × w₁ + x₂ × w₂ + Bias
Anschließend wird das Ergebnis durch eine sogenannte Aktivierungsfunktion geschickt.
Warum brauchen wir Aktivierungsfunktionen?
Eine Aktivierungsfunktion entscheidet vereinfacht gesagt, wie stark ein Neuron auf seine Eingaben reagiert.
Eine häufig verwendete Funktion ist ReLU (Rectified Linear Unit):
ReLU(x) = max(0, x)
Das bedeutet:
- Bei einer Eingabe von 5 liefert ReLU den Wert 5.
- Bei einer Eingabe von -3 liefert ReLU den Wert 0.
Aktivierungsfunktionen sind wichtig, weil neuronale Netze durch sie komplexe, nichtlineare Zusammenhänge lernen können. Ohne sie wären auch Netze mit vielen Schichten in ihrer Ausdruckskraft stark eingeschränkt. Ohne solche Aktivierungsfunktionen würde auch ein Netz aus mehreren Schichten mathematisch im Wesentlichen wie eine einzige lineare Transformation wirken.
Als Merksatz: ReLU lässt positive Werte durch und setzt negative Werte auf null.
Aber woher kommen die richtigen Gewichte?
Hier beginnt das eigentliche Lernen.
Am Anfang sind die Gewichte eines neuronalen Netzes noch nicht sinnvoll eingestellt. Das Netz produziert deshalb zunächst schlechte Ausgaben/Vorhersagen.
Beim Training läuft vereinfacht immer wieder derselbe Prozess ab:
Eingabedaten → Ausgabe/Vorhersage → Fehler berechnen → Gewichte anpassen → neue Ausgabe/Vorhersage
Angenommen, das Netz soll eine Wahrscheinlichkeit von 1 vorhersagen, liefert aber nur 0,3. Dann ist die Vorhersage offensichtlich noch nicht gut.
Eine sogenannte Loss-Funktion misst, wie groß der Fehler ist. Anschließend wird mit einem Verfahren namens Backpropagation berechnet, welche Gewichte für diesen Fehler verantwortlich waren.
Ein Optimierungsverfahren – beispielsweise Gradient Descent – verändert daraufhin die Gewichte ein kleines Stück in eine Richtung, die den Fehler voraussichtlich reduziert.
Dieser Vorgang wird sehr oft wiederholt.
Genau darin besteht das Training eines neuronalen Netzes.
Anwendungsbeispiel: Soll ein Kunde einen Kredit erhalten?
Stellen wir uns eine Bank vor, die ein sehr vereinfachtes neuronales Netz zur Einschätzung von Kreditanträgen verwendet. Als Ausgabe soll die Wahrscheinlichkeit auf Rückzahlung ermittelt werden.
Als Eingaben könnten beispielsweise dienen:
- Einkommen
- bestehende finanzielle Verpflichtungen
- Beschäftigungsdauer
- Höhe des gewünschten Kredits
Das neuronale Netz erhält diese Werte als Zahlen.
Einkommen ───────────┐
                     │
Verpflichtungen ─────┤       Hidden
                     ├──────► Layer ──────► Wahrscheinlichkeit für Rückzahlung
Beschäftigungsdauer ─┤
                     │
Kredithöhe ──────────┘
Nehmen wir an, das Netz liefert am Ende:
0,87
Das könnte als geschätzte Wahrscheinlichkeit von 87 % interpretiert werden, dass der Kredit entsprechend der im Training definierten Zielgröße zurückgezahlt wird.
Wichtig ist dabei: Das neuronale Netz kennt nicht automatisch Konzepte wie „guter Kunde“ oder „schlechter Kunde“. Es lernt statistische Zusammenhänge aus den Beispielen, die ihm während des Trainings gezeigt werden.
Wenn historische Trainingsdaten beispielsweise zeigen, dass bestimmte Kombinationen aus Einkommen, Kredithöhe und Verpflichtungen häufiger mit Rückzahlungen verbunden waren, kann das Netz diese Muster lernen.
Training und Anwendung sind zwei verschiedene Phasen
Bei neuronalen Netzen sollte man zwischen Training und Inference unterscheiden.
Während des Trainings bekommt das Netz viele Beispiele und passt seine Gewichte an.
Nach dem Training werden die Gewichte normalerweise nicht mehr bei jeder neuen Anfrage verändert. Stattdessen erhält das fertige Modell neue Daten und berechnet daraus eine Vorhersage. Dieser Vorgang wird Inference genannt.
Vereinfacht:
TRAINING

Trainingsdaten
     ↓
Neuronales Netz
     ↓
Vorhersage
     ↓
Fehler bestimmen
     ↓
Gewichte verändern
     ↺


ANWENDUNG

Neue Daten
     ↓
Trainiertes Netz
     ↓
Vorhersage
Was bedeutet „Deep Learning“?
Unser Beispielnetz besitzt nur eine kleine verborgene Schicht.
In der Praxis können neuronale Netze jedoch sehr viel größer sein und zahlreiche verborgene Schichten besitzen. Vereinfacht spricht man bei neuronalen Netzen mit mehreren Verarbeitungsschichten von Deep Learning.
Moderne Netze können Millionen oder sogar Milliarden von Parametern besitzen. Ein Parameter ist dabei typischerweise ein Gewicht oder Bias, dessen Wert während des Trainings gelernt wird.
Trotz ihrer enormen Größe basiert die grundlegende Idee weiterhin auf denselben Bausteinen:
Eingaben + Gewichte + Aktivierungsfunktionen + Fehlerberechnung + Optimierung
Ein wichtiger Punkt: Lernen bedeutet nicht Verstehen
Neuronale Netze können erstaunlich komplexe Zusammenhänge erkennen. Trotzdem sollte man ihre Funktionsweise nicht mit menschlichem Verständnis gleichsetzen.
Ein neuronales Netz lernt mathematische Muster in seinen Trainingsdaten. Die Qualität seiner Ergebnisse hängt deshalb stark davon ab, welche Daten verwendet wurden.
Sind Trainingsdaten fehlerhaft, unvollständig oder verzerrt, kann das Modell diese Probleme übernehmen. Gerade bei sensiblen Anwendungen wie Kreditentscheidungen, medizinischen Anwendungen oder Bewerbungsverfahren sind deshalb Datenqualität, Fairness, Transparenz und menschliche Kontrolle besonders wichtig.
Fazit
Ein kleines neuronales Netz lässt sich auf wenige Grundideen reduzieren:
Neuronen verarbeiten Zahlen.
Gewichte bestimmen, wie wichtig einzelne Eingaben sind.
Aktivierungsfunktionen ermöglichen komplexe Zusammenhänge.
Eine Loss-Funktion misst die Fehler des Netzes.
Durch Backpropagation und Optimierung werden die Gewichte verbessert.
Das eigentlich Faszinierende entsteht durch die Kombination dieser einfachen Bausteine. Werden sehr viele Neuronen miteinander verbunden und mit großen Datenmengen trainiert, können Systeme entstehen, die Bilder klassifizieren, Sprache verarbeiten, Vorhersagen treffen und viele weitere Aufgaben lösen.
Wer dieses Grundprinzip verstanden hat, besitzt bereits eine gute Grundlage, um sich als Nächstes mit Themen wie Gradient Descent, Backpropagation, Trainingsdaten und Deep Learning ausführlicher zu beschäftigen.
Hinweis: Dieser Beitrag wurde mit Hilfe von KI erstellt.